「AIは喋らなくていい」——TypeSafe「Jev」とMonadが暴いた、自律知能取引とSystem One革命の全真相
取引に300msごとの小論文はいらない。市場データを受け取り、型付き確率判定を下し、そのままオンチェーン板へ投げる。Monadのエンジニアが組み上げた自動取引ボットと、NeMo Switchyardのclassifier実測データから見えてきた、LLMの「小論文病」を脱するAIエージェントの新設計論。
プロローグ:Monadのエンジニアが24時間で作った「喋らないボット」
AI界隈でTypeSafeの旗艦モデル「Jev」が発表されるや否や、MonadのエンジニアはすでにJevを組み込んだ自律取引ボットを本番稼働させていた。
リアルタイムで流れてくるMON/USDCの価格データ。このボットにおいて、Jevは相場分析レポートを書く担当ではありません。マクロ経済の動向を饒舌に解説することもなければ、長大な論理展開を披露することもありません。
Jevが担うのはただ一つ。「Buyか、Sellか、Passか」を判定し、その信頼度(Confidence)を添えて、Kuruのオンチェーン・オーダーブック(Central Limit Order Book)へ直接指値・成行注文を投げることだけです。
「取引なんて、AIが300msごとに小作文書いてくれる必要なんてないんだよ。必要なのは:行情が入ってくる → 判断 → 注文 → 新行情 → 再判断。この一連のループが十分速く、十分安く回ることだ。」
この実装を見て、Jevがなぜ「喋らないモデル」として世に送り出されたのか、その理由が一気に腑に落ちます。
Monadはおよそ300ミリ秒ごとにブロックを生成し、Kuruは超高速なオンチェーン・オーダーブックを動かしています。
高性能チェーンが「執行」を担当し、Jevが「意思決定」を担当する。この2つが噛み合った瞬間、従来のWeb3ボットとも、従来のチャット型LLMとも根本から異なる「AIネイティブな自律取引システム」の輪郭が姿を現しました。
未来の自律取引エージェントに求められるのは、学術論文や投資調査レポートを執筆できる巨大なフロンティアモデルではありません。極限まで削ぎ落とされた低遅延で、何百万回もの連続判定をエラーなく刻み続けられる「冷徹な反射神経」なのです。
1. 「喋るAI」から「決めるAI」へのパラダイムシフト
LLMを無理やり文章生成器として使う時代は終わりました。テキストを介さず、ニューラルネットのサンプリング層から直接型付き確率値を出力することで、遅延と出力トークン課金をゼロにします。
2. NeMo実測が証明した「速度11倍・コスト1/12」の衝撃
NVIDIA NeMo Switchyardのルーティング分類器をJevに置き換えた実測では、DeepSeek比で11倍高速(0.64s)、Gemini比で桁違いの低コスト($0.000025)を達成。40回試行すべてで期待ティアと完全一致しました。
3. Monad×Kuru:自律取引ボットが実証したパターン4「代替」
LLMを完全にバイパスし、Jevが相場データから直接ミリ秒単位でオンチェーン板へ発注。高頻度・低コストが絶対条件となる金融工学・暗号資産取引で、System Oneが決定的な武器となります。
System Oneとは何か:LLMの「小論文病」をサンプリング層から撃ち落とす
なぜ私たちはこれまで、単なる4択判定や売買判断に何千トークンもの文章生成を強要されていたのでしょうか。
TypeSafe社は、構造化された意思決定に特化した新世代のAIプラットフォームです。その中核を担うモデル「Jev」は、同社によって「世界初のSystem One Model」と定義されています。
心理学者ダニエル・カーネマンが提唱した「ファスト&スロー」の概念を借りるなら、従来のLLM(GPT-4o、Claude 3.7 Sonnet、Gemini 2.5 Flash、DeepSeek R1など)は、文章を思考し、ステップ・バイ・ステップで論理を組み立てる「System Two(熟考・熟慮)」のエンジンです。
しかし現場のソフトウェアや取引システムが求める判断の多くは「System One(直感・反射的判定)」です。危険か安全か。AかBか。ルーティング先はどこか。買付か見送りか。
- 役割: 決める・見張る(超高速判定)
- 出力: 型付きプリミティブ(Choice, Score, Noul)
- 生成: テキストを出力しない。トークン生成待ち時間ゼロ
- 課金: 出力トークン代 完全無料(入力 $0.042/100万トークン)
- 特性: サンプリング層の確率分布をそのままConfidenceとして返却
- 役割: 文章を生成する(思考・創造・複雑な論理展開)
- 出力: 自然言語テキスト(Markdown, JSON文字列)
- 生成: 1文字ずつトークンを出力。長い思考(reasoning)を伴う
- 課金: 出力トークンに高額な単価が課される
- 特性: 判定結果を抽出するためにプロンプト工夫やパース処理が必要
Jevが提供する3つの基本プリミティブ
Jevには余計な会話プロンプトやチャット履歴の概念は存在しません。用意されているプリミティブは極めてシンプルに3種類に集約されています。
- Choice: 定義された選択肢リストの中から最適な1つを選択(確率・信頼度つき)。1フィールド255候補まで対応。
- Score: 与えられたルーブリック(評価基準)に基づき、スペクトラム上でスコア化。
- Noul: 指定された命題が真であるか偽であるかを0〜1の確率値で判定。
ベンチマーク実測:NeMo SwitchyardのclassifierをJevに替えたら何が起きたか
クラスメソッド マレーシアの森永大志氏(モリッシー)が実施した、NVIDIA NeMo Switchyardの分類器(classifier)置き換え検証。
NVIDIAが提供する次世代LLMルーティング基盤「NeMo Switchyard」。その llm-routing 方式は、直近4ターンの会話サマリを読み、リクエストを simple / medium / complex / reasoning の4段階に分類して最適なティアのLLMへ振り分ける設計を採用しています。
しかし、このclassifierに何を使うかで、現場のエンジニアは「地獄の二択」に直面していました。
| Classifierモデル | 推論方式 | レイテンシ (中央値) | コスト・トークン消費 | 現場の評価 |
|---|---|---|---|---|
| Gemini 3.5 Flash | LLM (Reasoning強制ON) | 2.1秒 | 1回 21,184トークン 65%がreasoning・$0.70/セッション |
高い 速いが振り分けだけで破産 |
| DeepSeek V4 Flash | LLM (Reasoning OFF) | 7.2秒 | reasoningトークン0 Gemini比 約1/12コスト |
遅い コストは安いが7秒待ち |
| TypeSafe Jev (Choice) | System One (構造化判定) | 0.64〜0.67秒 | $0.000025〜0.000027 出力トークン完全無料 |
圧倒的 トレードオフ解消 |
reasoningを許すLLMを使えば速いがコストが跳ね上がる。reasoningを止められるLLMに変えるとコストは下がるがレイテンシが壊滅する。
classifierは「4択のどれかを当てる」だけの軽いタスクのはずなのに、LLM本来のテキスト生成・reasoningの重厚な仕組みに引きずられてしまっていました。
40回試行の実測結果
4つの難易度ティアに対して各10回、合計40回のAPI呼び出しを行った結果、40回すべてで期待したティアと完全に一致しました。
| 分類ティア | 中央値レイテンシ | 平均レイテンシ | Confidence (信頼度) | 1回コスト |
|---|---|---|---|---|
| simple | 0.661秒 | 0.685秒 | 1.0 (迷いなし) | $0.000025 |
| medium | 0.651秒 | 0.690秒 | 0.57〜0.67 (揺らぎ) | $0.000025 |
| complex | 0.674秒 | 0.678秒 | 1.0 (迷いなし) | $0.000026 |
| reasoning | 0.643秒 | 0.652秒 | 1.0 (迷いなし) | $0.000027 |
特筆すべきは、mediumティアだけConfidenceが0.57〜0.67と低めに出現した点です。
人間にとっても「simple」と「complex」の狭間にある曖昧なタスクは判断に迷います。Jevはその確率的揺らぎをそのまま数値として返してきます。
「Confidenceが0.7未満なら安全側に倒して上位モデルへエスカレーションする」という設計が、正規表現ハックなしで1行で書ける。これは従来のLLMによるテキスト分類には存在しなかった圧倒的な実用性です。
完全解剖:JevとLLMの使い分け・5大配置パターン
それぞれの得意なことを活かし、安全で高品質なAIエージェントを実現する設計図。
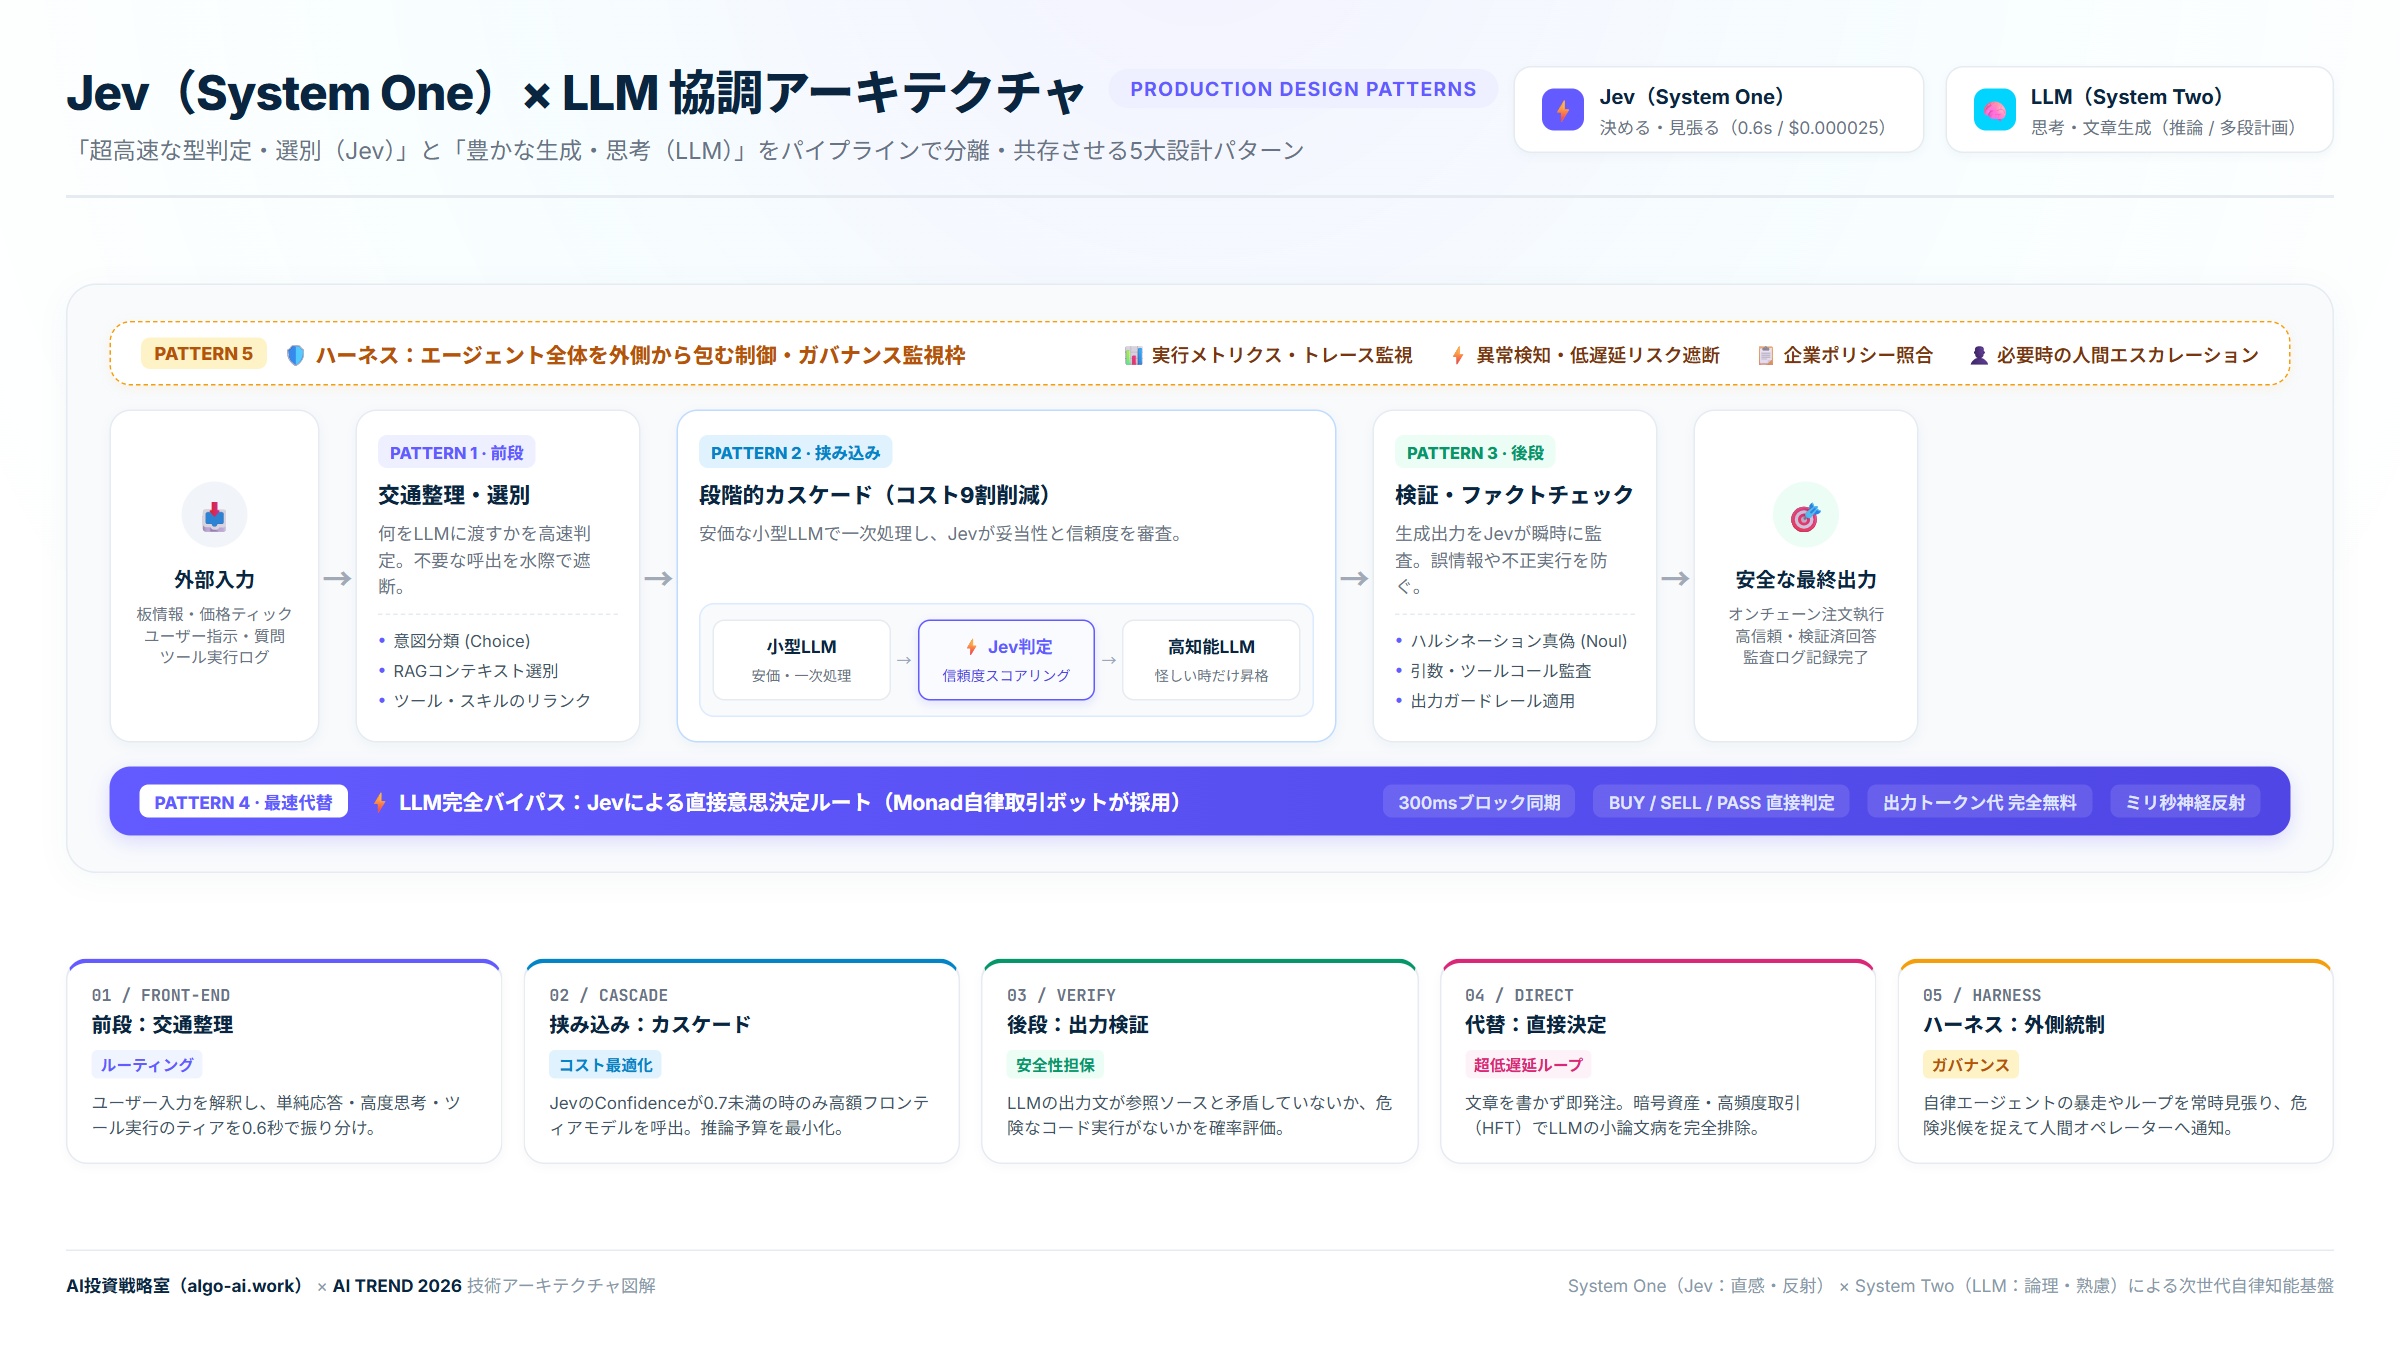
AIエージェントのアーキテクチャにおいて、すべての処理を単一の巨大LLMに委ねる時代は終わりました。
上記の設計図が示す通り、JevとLLMの協調には明確な5つの配置パターンが存在します。
「何をLLMに渡すか」を決める。 ユーザー入力を受け取り、意図分類やモデル選択、信頼度ゲートを通過させる。不要な質問はここで弾き、RAGゲートやスキルのリランクを超高速に行う。
「安いLLM → Jev → 高いLLM」。まずは小型LLMで安く高速に一次処理。その出力をJevが審査・判断し、妥当性や信頼度を評価。怪しいケースや低信頼度の時だけ、高性能LLMへエスカレーションする。
「LLMの出力を瞬時に判定する」。 LLMが生成したテキストにハルシネーションがないか、引用された事実が真実か、ツールコールが意図通りかをJevが監視。危険な回答や不整合を遮断する。
「生成せずJevが直接決める」。 LLMをバイパスする最短ルート。Yes/No判断、関数選択と引数充填、緊急対応。Monadの自動取引ボットが採用したのがまさにこのパターンです。
「エージェント全体を外側から包む安全枠」。 実行中のツール呼び出し判断や途中トレースの分類、実行後の応答方針照合。リスクの早期発見とポリシー適用、必要に応じた人間へのエスカレーションを担う。
パターン4「代替」が切り拓くオンチェーン取引の新常識
これまでのAI取引ボットの多くは、無理やりLLMにプロンプトを投げていました。
「現在のMACDは○○、RSIは○○です。あなたは凄腕トレーダーです。理由を説明した上でJSONで {“action": “BUY"} と答えてください」と。
このアプローチは2つの意味で破綻しています。
- 速度の破綻: LLMが「相場は現在上昇トレンドにあり…」とトークンを打鍵している数百ミリ秒の間に、板のプライスは滑り、アービトラージの機会は消滅する。
- コストの破綻: 1秒に数回のティックが入る市場で毎秒LLMを叩けば、1日で数万円〜数十万円のAPI利用料が溶け、取引利益を丸ごと食い尽くす。
Jevのパターン4(代替ルート)であれば、市場データをそのまま突っ込んでChoiceで「BUY / SELL / HOLD」の確率分布を0.6秒、1回あたり0.003円で引き抜けます。
Monadのような超高速レイヤー1と直結させるべきは、雄弁な批評家ではなく、この電光石火のトリガーなのです。
誇大妄想を捨てる:Jevの現実と「トレードオフ」の直視
万能の神薬ではない。速度とコストを極振りしたモデルが直面する精度の限界。
熱狂に水を差すようですが、Jevを本番に投入するなら冷徹に直視すべき事実があります。
第一に、TypeSafe Jevは2026年9月時点でアーリーアクセス(ウェイトリスト制)の段階にあり、APIの仕様や料金、インフラの挙動は今後激しく変動する可能性があります。
第二に、TypeSafeの売りは「速度とコスト」であって、「ずば抜けた精度」ではない点です。
つまり、Jevは「複雑な法律相談」や「精緻な数理証明」を解かせるためのモデルではありません。
精度が1ポイント違うだけで致命傷になる業務では、Jev単独で完結させてはならないのです。
だからこそ、前述の「パターン2(挟み込み)」のように、Jevが低Confidenceを出した瞬間だけ重厚なフロンティアLLMにバトンを渡すカスケード設計が真の勝負所になります。
エピローグ:取引Agentの未来は「論文執筆者」ではなく「無口な反射神経」
高性能チェーン(Monad)× オンチェーン板(Kuru)× System One(Jev)。
AIエージェントの進化は「より賢く、より長文を話す方向」にばかり向いていました。だが実社会のインフラが求めていたのは、その真逆——「何も喋らず、ただ型通りに、光の速さで決断を下すAI」でした。
300msのブロックタイムで駆け抜けるMonadと、オンチェーン板のKuru。
そこにJevのChoiceが合流した瞬間、AI取引ボットは「人間のトレーダーを模倣したチャットボット」から「自律知能そのものによるミリ秒単位の神経反射」へと進化を遂げました。
文章を書くならLLMに任せればいい。
だが、決めるなら、見張るなら、あるいは市場に注文を叩き込むなら、選ぶべきはSystem Oneです。
AIエージェントのアーキテクチャは、今まさに新たな分岐点を迎えています。
2. 高頻度オンチェーン取引の解禁:Monadなどの超低遅延L1とSystem Oneの結合により、完全自律型のマーケットメイク・アービトラージボットが実用段階へ。
3. カスケード配置によるROI極大化:通常判定は0.6秒・$0.000025のJevで処理し、低Confidence時のみ重厚LLMへエスカレーションすることで、推論コストを9割以上削減できる。